
Cómo posicionar en Perplexity AI: fuentes primarias, foros y carrusel de citas
De todos los asistentes y motores de búsqueda basados en inteligencia artificial que han salido al mercado, hay uno que destaca por encima del resto para quienes vivimos del tráfico web: Perplexity AI.
Mientras que ChatGPT o Gemini a menudo se comportan como oráculos que sintetizan respuestas sin dar enlaces (a menos que el usuario se los pida expresamente), Perplexity nació con una filosofía radicalmente distinta.
Se define a sí mismo como un motor de respuestas transparente.
Cada frase que genera viene acompañada de una llamada numérica entre corchetes [1], [2] que enlaza directamente a la página web de donde ha extraído el dato, coronando la respuesta con un carrusel de fuentes visible en la parte superior.
Esto convierte a Perplexity en el buscador generativo que más tráfico de referencia y de mayor cualificación está enviando ahora mismo a los proyectos digitales.
Pero ganarse un hueco en ese carrusel no funciona igual que posicionar en las diez URLs de Google.
Analizando la documentación técnica oficial de la compañía, las declaraciones de su equipo de ingeniería (liderado por su CTO, Denis Yarats) y el comportamiento real de sus citaciones, he desgranado los engranajes que hacen que este motor elija a una web frente a otra.
Cómo funciona Perplexity por dentro (sin tecnicismos de laboratorio)
Para optimizar tu web para Perplexity, primero tienes que visualizar qué ocurre entre bambalinas desde que un usuario pulsa intro hasta que aparece el texto en pantalla.
Google rastrea la red, almacena las páginas en un índice gigantesco y te muestra una lista ordenada de enlaces.
Perplexity, en cambio, ejecuta un proceso en cuatro pasos en menos de medio segundo:
- Reescribe la consulta: Si el usuario escribe una duda conversacional o una pregunta compleja con matices, un modelo de lenguaje interno la descompone en varias búsquedas técnicas más precisas.
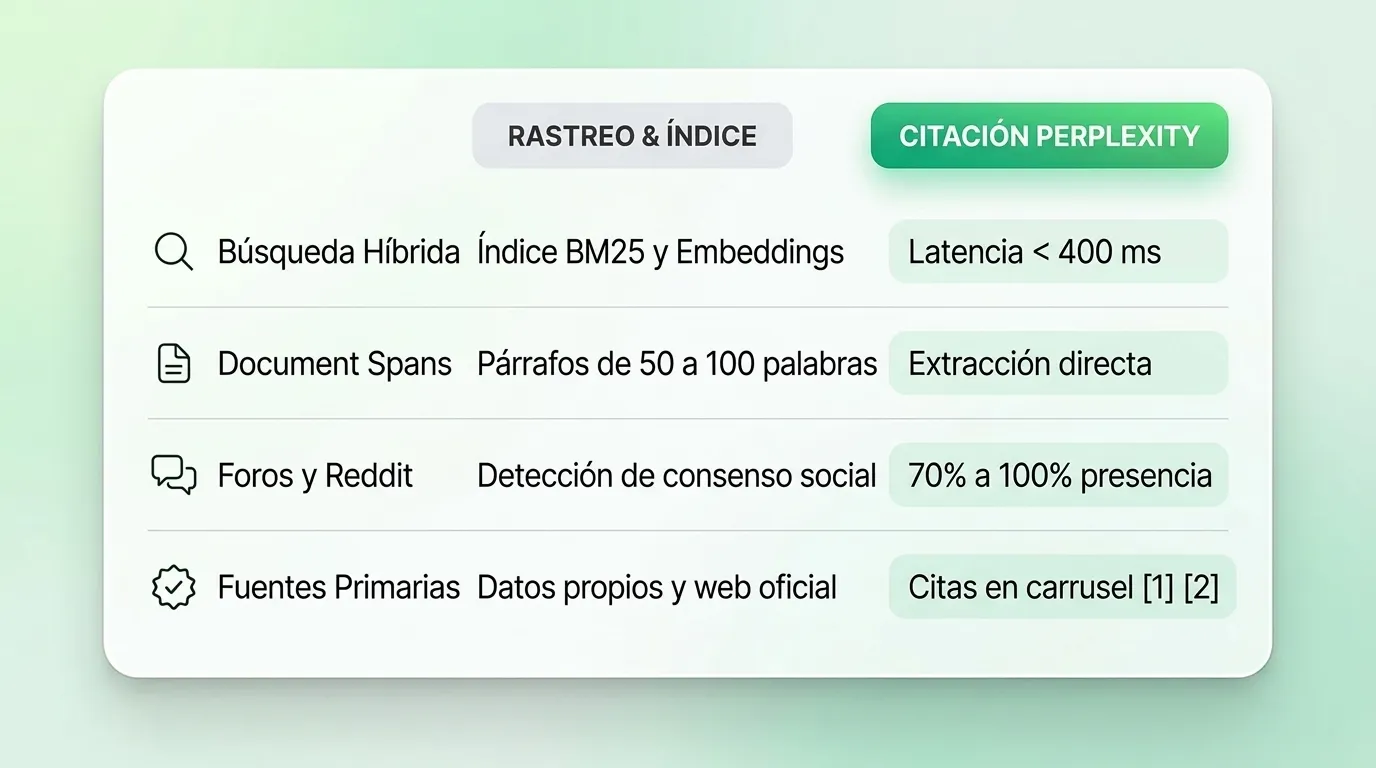
- Lanza una búsqueda híbrida en tiempo real: Acude a la web viva mediante su propio índice y motores auxiliares combinando búsqueda por palabras clave clásica (BM25) con búsqueda semántica por similitud de conceptos.
- Filtra y reordena los mejores pasajes: Un algoritmo de reranking examina los fragmentos recuperados para descartar el relleno y seleccionar únicamente los tres o cuatro tramos de texto con mayor densidad de datos y veracidad.
- Sintetiza y asigna las citas: El modelo redacta la respuesta apoyándose exclusivamente en esos fragmentos seleccionados e incrusta el enlace a cada fuente original.
El resumen es demoledor: Perplexity no recomienda webs completas; recomienda fragmentos específicos que resuelven una duda con absoluta certeza.
Los dos rastreadores de Perplexity (y el error de bulto con el WAF)
A nivel técnico, conviene tener muy clara una distinción que la propia documentación de Perplexity recalca y que confunde a muchos desarrolladores: la empresa utiliza dos agentes diferentes.
- PerplexityBot: Es su crawler automatizado de fondo. Rastrea e indexa páginas públicas para alimentar su índice interno de búsqueda. La compañía especifica oficialmente que este bot no se utiliza para entrenar modelos de IA fundacionales, sino solo para indexar y enlazar sitios web. Respeta las directivas estándar del archivo
robots.txt. - Perplexity-User: Es el agente que se activa en tiempo real cuando un usuario concreto realiza una consulta interactiva en la plataforma o introduce una URL específica. Al ser una petición expresa de un usuario humano, suele saltarse ciertas directivas de bloqueo.
¿Dónde está el problema operativo que veo en muchas auditorías?
En los cortafuegos de aplicaciones web (WAF) como Cloudflare o AWS Shield.
Muchos sistemas de seguridad detectan las peticiones automatizadas de PerplexityBot y, al ver un volumen rápido de consultas, las catalogan por error como un ataque o les lanzan un CAPTCHA.
Si el bot se topa con un muro de seguridad o con un reto visual, no puede leer tu página, se marcha con las manos vacías y tu enlace desaparece de las opciones de cita. Comprobar que tu cortafuegos no está bloqueando su User-Agent es el primer paso obligatorio.
El factor clave: el principio de los ‘Document Spans’
Si hay un concepto técnico que define cómo lee Perplexity el contenido de tu web, es lo que su equipo de ingeniería denomina Document Spans (tramos o pasajes de documento).
Denis Yarats (CTO de Perplexity) ha explicado que su motor no procesa una página web como un bloque monolítico indivisible.
El sistema divide el texto en fragmentos autónomos de entre 50 y 150 palabras.
Cuando el algoritmo de búsqueda híbrida recupera información, no evalúa si tu artículo de 3.000 palabras es genial en su conjunto. Lo que evalúa es si un párrafo concreto resuelve con máxima precisión el fragmento de la duda que el usuario ha planteado.
Esto nos obliga a cambiar radicalmente la forma de redactar si queremos aparecer en sus citas:
- La respuesta directa en las primeras 50 palabras: Inmediatamente después de cada encabezado H2 o H3, debes dar la respuesta directa a la pregunta sin rodeos. Nada de introducciones vacías como “A lo largo de la historia, muchas personas se han preguntado si…”. Ve directo al dato.
- Autonomía contextual: Cada sección debe poder leerse y entenderse si alguien la recorta con una tijera y la pega en una hoja en blanco. Si para entender el párrafo necesitas haber leído los tres apartados anteriores, el modelo RAG no podrá usarlo como cita independiente.
- Estructura en tablas y cifras compactas: A los algoritmos de síntesis les resulta infinitamente más fácil extraer un dato exacto de una tabla comparativa limpia o de una lista numerada que de tres párrafos densos de prosa literaria.
En Perplexity, la concisión y la precisión técnica en el párrafo inicial de cada bloque valen más que mil palabras de florituras.
La fórmula híbrida: fuentes primarias y presencia en foros
Uno de los estudios de citación más reveladores de la industria (elaborado por LumenGEO tras analizar miles de respuestas comerciales en Perplexity) arrojó un dato que a primera vista parece contradictorio:
Los hilos de Reddit aparecen consultados en entre el 70% y el 100% de las respuestas sobre productos y servicios.
Sin embargo, los enlaces directos a Reddit solo representan entre el 10% y el 12% del total de citas finales en el carrusel de fuentes.
¿Qué nos dice este patrón sobre el cerebro de Perplexity?
Nos dice que el motor utiliza las comunidades, los foros y las redes sociales para tomarle el pulso al mercado: acude a Reddit o a foros del sector para descubrir qué marcas recomienda la gente real, qué problemas mencionan los usuarios y cuál es el consenso de la comunidad.
Pero cuando tiene que redactar la respuesta final y colocar enlaces de autoridad, necesita apoyarse en fuentes primarias:
- Documentación técnica oficial y páginas de especificaciones del fabricante o proveedor.
- Artículos de fondo con datos propios, estudios sectoriales y opiniones profesionales firmadas.
- Guías paso a paso que desglosen la metodología con rigor.
Esto derriba dos mitos de un plumazo.
No basta con tener una página web perfecta si nadie habla de ti en foros, medios y comunidades exteriores. Y tampoco sirve de nada intentar colar spam en Reddit si detrás no hay una web con contenido técnico sólido que Perplexity pueda utilizar como referencia primaria.
La visibilidad en este buscador es una pinza: el ecosistema externo valida tu reputación, y tu propia web aporta la sustancia técnica para ser citada.
Recomendaciones estratégicas para ganar presencia en Perplexity
El algoritmo de Perplexity evoluciona a un ritmo vertiginoso, pero los principios de ingeniería en los que se sustenta su modelo de respuesta son estables.
Para que tu proyecto empiece a captar visibilidad y clics desde este canal, enfoca tus esfuerzos en estas líneas de trabajo atemporales:
- Favorece el HTML limpio frente al renderizado masivo de JavaScript: Perplexity necesita velocidad extrema (su fase de recuperación opera en menos de 400 milisegundos). Las webs que entregan HTML limpio desde el servidor permiten que sus agentes extraigan fragmentos sin la lentitud que provocan los scripts pesados del lado del cliente.
- Diseña tus H2 y H3 como preguntas directas del usuario: Titula tus apartados exactamente como la gente formula sus dudas en el buscador (ej. “Cómo calcular X”, “Qué diferencia hay entre A y B”).
- Coloca el dato o la conclusión en la primera línea: No guardes la respuesta para el final del artículo. Responde de forma contundente en la primera o segunda frase de cada sección y utiliza el resto del bloque para aportar contexto, matices y datos cuantitativos.
- Siembra tu marca en el ecosistema exterior de forma legítima: Participa en debates de tu sector, colabora en medios especializados y consigue que tu empresa aparezca en comparativas independientes. Si la IA encuentra consenso sobre tu trabajo en varias fuentes de terceros, te colocará en el carrusel superior con total naturalidad.
Perplexity ha demostrado que los usuarios no solo quieren que una IA les hable; quieren saber de dónde sale la información y poder hacer clic para profundizar o contratar.
Si quieres auditar cómo leen los nuevos motores de respuesta los activos de tu empresa y necesitas una hoja de ruta para que tu web empiece a liderar las citas en tu sector, puedes echar un vistazo a mi servicio de consultor GEO donde analizamos en profundidad la presencia de tu marca en IA.