
Cómo creé mi propio crawler SEO con IA (y por qué dejé de usar Screaming Frog)
Los consultores SEO llevamos prácticamente toda la vida dependiendo de Screaming Frog.
Es una herramienta histórica, completísima y que funciona de maravilla para rastrear páginas web, extraer etiquetas del código fuente y auditar problemas técnicos. Sin embargo, hace un par de meses me hice una pregunta que me cambió la rutina de trabajo: ¿por qué sigo adaptándome a las limitaciones de un software de terceros si hoy puedo construir mi propia herramienta a medida con inteligencia artificial?
Dicho y hecho: me puse manos a la obra y programé mi propio crawler personalizado al 100% para las necesidades que tengo en mi día a día.
El resultado ha sido tan rotundo que literalmente he dejado de usar Screaming Frog. Mi herramienta no solo vuela rastreando portales, sino que está conectada directamente con agentes de inteligencia artificial y con las APIs de mis clientes.
En este artículo y en el vídeo que te dejo arriba te enseño cómo es por dentro, qué arquitectura técnica utiliza y cómo puedes programar tú mismo una solución equivalente en cuestión de minutos.
Cómo es mi herramienta por dentro: configuración, concurrencia y extracción limpia
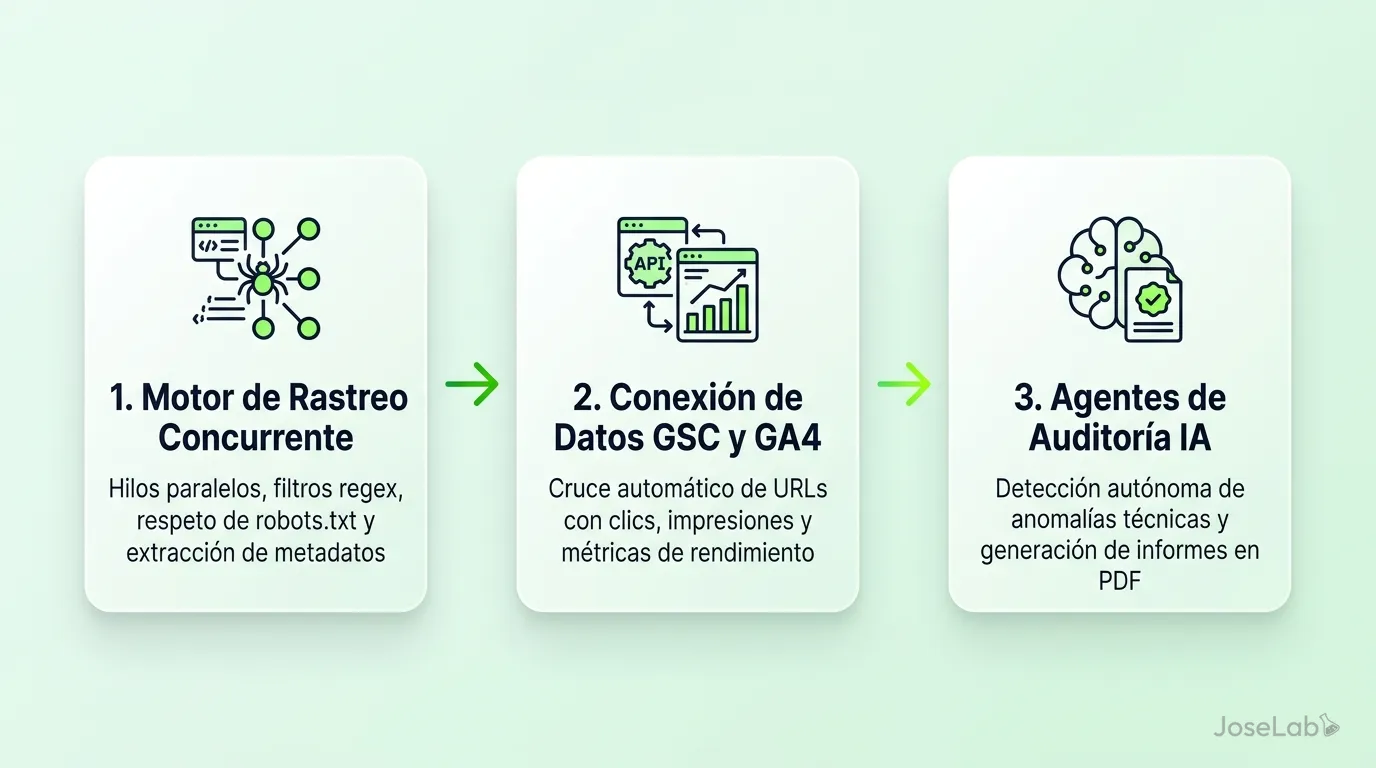
Mi crawler personalizado replica lo más útil del rastreo técnico tradicional pero elimina toda la complejidad innecesaria: permite ajustar la concurrencia de hilos paralelos, fijar límites de URLs, aplicar filtros por expresiones regulares y extraer metadatos limpios en tiempo real.
En el panel de control tengo una interfaz gráfica muy directa donde introduzco la URL de inicio del proyecto y configuro los parámetros exactos que necesito para ese rastreo concreto:
- Concurrencia máxima y límite de velocidad: Defino cuántos hilos o peticiones paralelas lanzo al servidor para rastrear lo más rápido posible sin tumbar la web del cliente.
- Límites de volumen: Si audito un portal enorme de más de 50.000 URLs y solo quiero validar una muestra de 5.000 o 10.000 páginas, limito el alcance con un solo clic.
- Tipos de recursos seleccionables: Elijo si quiero rastrear imágenes, subdominios, enlaces externos, paginaciones o únicamente páginas HTML.
- Reglas de exclusión con Regex: Si hay parámetros de tracking, filtros de tienda o directorios privados que no aportan nada a la auditoría, los excluyo mediante expresiones regulares para ahorrar tiempo y recursos.
- Respeto de directivas: Comprobación estricta del archivo
robots.txty validación de etiquetas canonicals para simular el comportamiento real de los buscadores.
Una vez lanzado el rastreo, el panel lateral me muestra en vivo la tabla completa con cada URL descubierta: metatítulo, longitud de caracteres, metadescripción, código de respuesta HTTP (200, 301, 404, etc.), indexabilidad, canonical y tiempo de carga exacto en milisegundos.
Tengo justo los datos que necesito para trabajar, organizados como a mí me gusta y sin menús sobrecargados de opciones que nunca llego a utilizar.
La verdadera ventaja competitiva: conexión nativa con GSC, GA4 y agentes de IA
El salto cualitativo real frente a un software comercial cerrado reside en la integración nativa con las APIs de analítica y el ecosistema de agentes inteligentes, permitiendo cruzar datos de rastreo con métricas de negocio en un solo paso.
En Screaming Frog, para cruzar los datos de rastreo con Google Search Console o Google Analytics 4 tienes que configurar integraciones de API manuales en cada máquina, lidiar con límites de cuota y exportar tablas gigantes para cruzarlas en Excel o BigQuery.
En mi herramienta lo tengo resuelto con un menú desplegable de clientes:
- Cruce inmediato con GSC y GA4: Selecciono el nombre del cliente, indico el rango de fechas y la herramienta cruza de forma automática cada URL rastreada con sus clics, impresiones, CTR medio y sesiones reales.
- Conexión directa con agentes de IA: Como toda la arquitectura está montada en mi entorno de trabajo con Antigravity, no dependo de interfaces rígidas. Puedo abrir el chat con mi agente y pedirle: «Lanza un rastreo completo a este cliente, aíslame las URLs indexables que no reciben impresiones en Search Console y móntame un informe técnico en PDF listo para enviar».
El agente ejecuta el comando, filtra la información técnica, redacta el diagnóstico y genera el documento en minutos. Esta capacidad de orquestación convierte a un simple crawler en un sistema operativo de auditoría continua.
Claves para elegir la tecnología antes de escribir una sola línea de código
Antes de pedirle a un modelo de lenguaje que programe tu crawler, es imprescindible definir la escala del proyecto y la tecnología base para evitar quedarte sin margen de maniobra meses después cuando quieras añadir funciones complejas.
Te lo digo por experiencia propia: me ha ocurrido en el pasado programar pequeñas herramientas donde no planifiqué bien la arquitectura inicial y, al querer meter concurrencia masiva o conexiones pesadas, la tecnología elegida no daba más de sí y tuve que rehacer prácticamente todo desde cero.
Para no cometer ese error, ten en cuenta estas pautas:
- Evalúa el volumen de URLs: No es lo mismo auditar blogs o webs corporativas de 300 páginas que rastrear e-commerce gigantes con 100.000 referencias. Para proyectos medianos y rápidos, Python (usando librerías como
httpx,BeautifulSoupoPlaywrightsi necesitas renderizar JavaScript) es insuperable en flexibilidad y velocidad de desarrollo. Si vas a procesar millones de páginas a velocidad extrema, tecnologías como Rust o Go ofrecen un control de memoria y concurrencia brutal. - Alimenta a la IA con documentación real: Si no tienes claro qué funciones debe tener un crawler profesional, acude a la documentación pública de Screaming Frog o herramientas similares. Pásale a tu modelo de IA las secciones de documentación para que entienda qué campos debe extraer (OpenGraph, encabezados H1-H6, directivas de robots, peso del DOM).
- Especifica tus requerimientos desde el principio: Dile a la IA qué dependencias vas a utilizar, cómo quieres estructurar la base de datos (SQLite suele ser perfecta para empezar) y qué tipo de visualización necesitas. Cuanto más claro sea el plan técnico inicial, más limpio y escalable será el código que genere.
El prompt real para programar tu propio crawler funcional en 4 minutos
Con un modelo de lenguaje estándar y un prompt directo que detalle la lógica de descubrimiento y extracción, puedes obtener un crawler operativo con interfaz web en menos de cinco minutos.
En el vídeo hice la prueba en directo pidiéndole algo tan directo como esto a un modelo de IA:
Haz un crawler en Python que me permita rastrear cualquier página web.
Yo te pasaré una URL de inicio y tú deberás seguir todos los enlaces internos
que tenga esa página (y los enlaces externos de forma opcional) para descubrir
todos sus contenidos.

Utiliza la tecnología que consideres más conveniente para la interfaz y el backend.
No hace falta que visualmente sea algo espectacular, pero sí debe permitirme
tener los principales datos a mano para auditar la web: códigos de respuesta HTTP,
tiempos de carga, metatítulos, metadescripciones, canonicals, etiquetas de robots,
encabezados H1, OpenGraph y conteo de palabras del cuerpo.
El modelo tardó exactamente 4 minutos en plantear el plan de implementación, instalar las dependencias necesarias en un entorno virtual, programar el backend con servidor local y montar un frontend funcional con scroll lateral y filtros por columnas.
Al lanzarlo y probarlo con una profundidad de rastreo de 7 niveles y 200 páginas de muestra, el crawler extrajo a la perfección los códigos de estado, las etiquetas canonicals, el tiempo de respuesta del servidor y el recuento de caracteres de cada metatítulo.
Una base funcional impecable que después puedes ir refinando con funciones avanzadas según lo que tú necesites.
¿Vale la pena crear tu propio software en la era de la IA?
La vieja creencia de que nunca merece la pena programar tu propio software si ya existe una herramienta en el mercado ha quedado totalmente desfasada gracias a la programación asistida por IA.
Hace poco leía a alguien defender que hacer tus propias herramientas es una pérdida de tiempo porque el desarrollo siempre se llena de errores (bugs) y cuesta demasiado mantenerlo. Estoy en desacuerdo total.
Antes, crear un software a medida exigía meses de trabajo, miles de euros en desarrollo y una dependencia constante de programadores para arreglar cualquier fallo. Hoy en día, si surge un error o necesitas añadir una funcionalidad específica, abres el chat con la IA, le pegas el log del fallo o le explicas el ajuste que necesitas y te lo resuelve en segundos.
La ventaja competitiva de tener un software propio no es ahorrarte la licencia de una herramienta externa; es la agilidad operativa de trabajar con un sistema diseñado al milímetro para tus clientes y tus procesos.
Poder cruzar datos con tus APIs en un solo clic y conectar tu rastreador con agentes inteligentes te ahorra decenas de horas de trabajo manual cada semana. Si tienes curiosidad por trastear, te animo a que abras tu entorno de IA favorito y empieces a construir tus propias soluciones. La diferencia en productividad es abismal.