
El archivo llms.txt: qué es, cómo estructurarlo y plantilla lista para implementar
Durante los últimos meses se ha empezado a hablar con fuerza en la comunidad tecnológica de un nuevo archivo para la raíz de nuestras webs: el archivo llms.txt.
Antes de entrar en materia técnica, quiero dejar clara una advertencia de honestidad profesional: Google no ha dicho de forma oficial que utilice este archivo ni existe ningún organismo internacional que lo haya homologado como estándar web obligatorio.
Si alguien te intenta vender que sin un llms.txt tu web va a desaparecer de los buscadores mañana por la mañana, te está vendiendo humo.
Ahora bien, hecha esa aclaración, la realidad práctica del mercado es muy distinta.
Existen multitud de agentes de inteligencia artificial autónomos, herramientas de desarrollo (como Cursor) y rastreadores de modelos de lenguaje (como los asistentes de OpenAI, Anthropic o Perplexity) que, cuando acceden a un dominio para recopilar información o responder a una consulta concreta, comprueban activamente si existe este archivo en la raíz del servidor.
Implementarlo te cuesta apenas quince minutos, tiene un riesgo técnico absolutamente nulo y te sitúa un paso por delante a la hora de alimentar a los modelos con información fidedigna sobre tu negocio.
Qué es exactamente el archivo llms.txt y por qué nació
La propuesta de este formato nació de la mano de Jeremy Howard (fundador de Answer.AI y referente en el ecosistema de aprendizaje automático) bajo una premisa aplastantemente lógica: la web moderna está diseñada para humanos con ojos, no para modelos de lenguaje.
Cuando un bot de inteligencia artificial intenta leer una página corporativa habitual para entender qué vendes, se encuentra con un muro de ruido: menús de navegación desplegables, banners de cookies, llamadas a scripts de analítica, formularios intrusivos y código CSS kilométrico.
Todo ese envoltorio obliga al modelo a malgastar tiempo y cientos de tokens simplemente limpiando la basura antes de llegar a la información útil.
El archivo llms.txt funciona bajo el mismo espíritu con el que nació el clásico robots.txt en los años noventa:
- Se aloja siempre en la raíz de tu dominio (
tudominio.com/llms.txt). - Está escrito en Markdown plano, el formato nativo que mejor y más rápido digieren los modelos de lenguaje.
- Actúa como un índice ejecutivo curado, reuniendo en un solo documento los enlaces limpios y las explicaciones esenciales de qué hace tu empresa, qué servicios ofreces y cuáles son tus documentos de mayor autoridad.
El resultado es directo: cuando un agente de IA consulta tu dominio, en lugar de perderse por un laberinto de URLs lentas, lee este resumen sintético en una fracción de segundo y extrae tus datos sin inventarse nada.
Mi opinión sobre llms.txt vs llms-full.txt: mantén las cosas simples
En la propuesta inicial del formato se planteaba la existencia de dos archivos complementarios:
/llms.txt: Un índice ligero con enlaces y descripciones breves de una línea por recurso./llms-full.txt: Una versión gigantesca que concatena directamente dentro del mismo archivo todo el texto íntegro de la web o de la documentación técnica.
Mi recomendación profesional para el 90% de los negocios es clara: olvídate de crear dos archivos distintos y céntrate en tener un único llms.txt impecable.
Salvo que gestiones una librería de software descomunal con cientos de funciones o una plataforma técnica de enorme complejidad, mantener dos archivos sincronizados solo te va a generar trabajo duplicado y desactualizaciones constantes.
Para una empresa de servicios, una agencia, un ecommerce o un proyecto digital mediano, un único archivo llms.txt conciso y bien planteado es más que suficiente para condensar la propuesta de valor, los servicios troncales y las respuestas clave que necesita la IA.
Plantilla lista para implementar: la estructura paso a paso
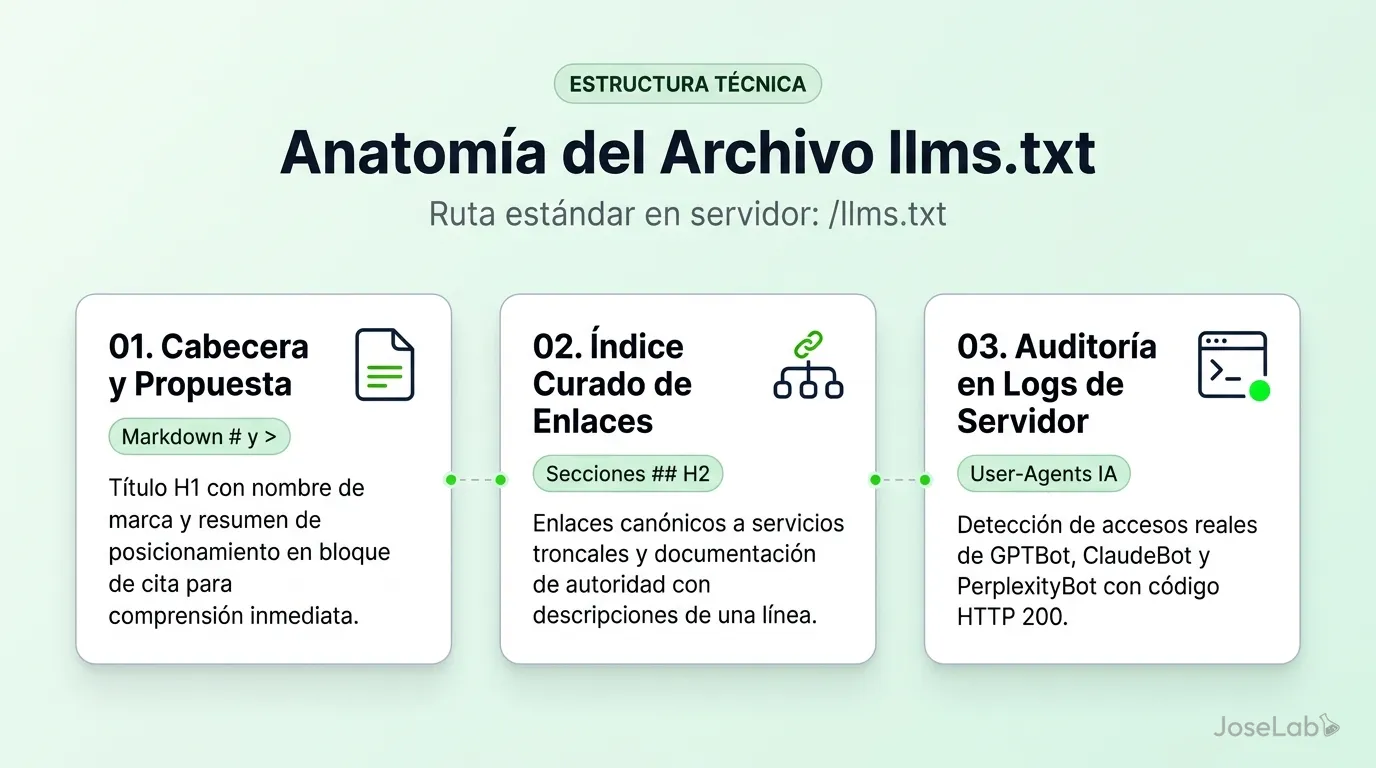
El estándar propuesto exige una jerarquía visual muy limpia para que los parsers automáticos no tengan problemas de lectura.
Se compone de cuatro bloques fundamentales:
- Título principal (
# H1): El nombre comercial de tu marca o proyecto. - Resumen de posicionamiento (
> blockquote): Una o dos frases directas que explican a qué te dedicas y cuál es tu propuesta de valor principal. - Secciones temáticas (
## H2): Bloques ordenados por categorías (Servicios, Recursos, Datos de la empresa, Contacto). - Listados con enlaces y descripciones cortas: Enlaces en sintaxis Markdown acompañados obligatoriamente de un guion y una frase breve que aclare qué contiene cada enlace.
Aquí tienes una plantilla base profesional lista para que la adaptes a tu proyecto:
# JoseLab

> Consultoría especializada en Generative Engine Optimization (GEO), SEO técnico avanzado y analítica digital orientada a resultados.

## Servicios Principales

- [Consultoría GEO para Motores de IA](https://joselab.com/consultor-geo/): Estrategia técnica y de autoridad para posicionar marcas y contenidos en ChatGPT, Perplexity y Google AI Overviews.
- [Auditoría SEO Técnica](https://joselab.com/consultor-seo-alicante/): Diagnóstico exhaustivo de rastreo, indexación, Core Web Vitals y arquitectura web para empresas y ecommerce.
- [SEO para Ecommerce](https://joselab.com/blog/categoria/seo/): Optimización de catálogo, arquitectura de categorías y conversión orgánica para tiendas online.

## Artículos y Recursos Clave

- [Qué es GEO](https://joselab.com/que-es-geo-generative-engine-optimization/): Guía completa sobre los pilares del posicionamiento en buscadores generativos y RAG.
- [SEO vs GEO](https://joselab.com/seo-tradicional-vs-geo/): Comparativa detallada entre el posicionamiento tradicional en enlaces azules y la citación en IA.
- [Cómo posicionar en Perplexity](https://joselab.com/como-posicionar-en-perplexity-ai/): Análisis forense del motor de Perplexity, el principio de los Document Spans y el carrusel de fuentes.
- [Datos estructurados para IA](https://joselab.com/datos-estructurados-para-ia/): Implementación avanzada de Schema JSON-LD (sameAs, knowsAbout) para desambiguación de entidades.

## Información de la Empresa y Autoridad

- [Sobre JoseLab](https://joselab.com/): Perfil profesional, trayectoria de más de una década en el sector y enfoque de trabajo.
- [Contacto](https://joselab.com/contacto/): Formulario directo de solicitud de presupuesto y consulta de proyectos.
El método rápido: cómo redactar tu archivo con tu modelo de IA favorito
No hace falta que pases horas picando código o redactando resúmenes desde cero.
Un método extraordinariamente ágil y práctico consiste en pedirle a tu modelo de lenguaje favorito (ChatGPT, Claude o Perplexity) que navegue por las páginas principales de tu web y redacte el borrador del archivo por ti.
Puedes utilizar un prompt como este (ajustándolo a tu negocio):
Actúa como un consultor técnico especializado en GEO (Generative Engine Optimization).

Visita y analiza las siguientes URLs principales de mi negocio:
- [Pega la URL de tu Home]
- [Pega la URL de tu página de Servicios o Catálogo]
- [Pega la URL de Sobre Mí / Empresa]
- [Pega 3 o 4 URLs de tus mejores artículos o guías]

Con la información extraída, genera el contenido exacto para un archivo llms.txt cumpliendo estas especificaciones:
1. Encabezado H1 con el nombre de la empresa.
2. Un bloque de cita (> blockquote) de máximo dos líneas definiendo la especialidad y propuesta de valor única.
3. Secciones H2 organizadas lógicamente (Servicios troncales, Recursos recomendados, Información corporativa).
4. Enlaces en formato Markdown [Texto descriptivo](URL) seguidos de dos puntos y una frase muy breve y directa que resuma el beneficio o contenido de esa página.
5. Cero relleno comercial ni adjetivos grandilocuentes; redacción puramente factual y concisa en español.
Una vez que el modelo te devuelva la respuesta, revisa que los enlaces apunten a las URLs canónicas correctas, guárdalo con el nombre llms.txt y súbelo a la carpeta raíz de tu servidor (en plataformas como WordPress se sube vía FTP o gestor de archivos a public_html/llms.txt, y en frameworks como Astro o Next.js se coloca dentro de la carpeta /public/).
Cómo auditar si los bots de IA están leyendo tu archivo: análisis de logs
Aquí es donde separamos la teoría de la realidad técnica: ¿cómo puedes saber con certeza absoluta si los bots de inteligencia artificial leen de verdad tu archivo llms.txt?
La única respuesta fiable no está en Google Analytics ni en paneles de terceros; está en los logs del servidor web.
Cada vez que cualquier agente, crawler o usuario humano solicita un recurso de tu web, el servidor (ya sea Nginx, Apache, LiteSpeed o la capa perimetral de Cloudflare) registra una línea en su historial de accesos con tres datos reveladores:
- La URL solicitada: En este caso,
/llms.txt. - La fecha y hora exacta con el código de respuesta HTTP devuelto (un 200 si lo leyó correctamente).
- El User-Agent: La firma que identifica a la máquina que hace la petición.
Descargando estos registros periódicamente y filtrando las solicitudes que contienen la cadena /llms.txt, puedes descubrir si rastreadores como GPTBot, ClaudeBot, PerplexityBot o agentes de asistentes conversacionales están accediendo a tu índice.
Como consultor SEO, este análisis forense de logs es una tarea que realizo habitualmente para muchos clientes. Es la única auditoría que te permite verificar si la inversión de tiempo que haces en optimizaciones técnicas para IA se traduce en visitas y lecturas reales de los motores generativos, o si por el contrario tus directivas de servidor están bloqueando a los agentes sin que te des cuenta.
Implementar tu archivo llms.txt apenas te llevará unos minutos y le dejará las puertas abiertas a los modelos de lenguaje para que entiendan con total nitidez a qué te dedicas.
Si quieres auditar a fondo la accesibilidad de tu web para los motores de inteligencia artificial o necesitas diseñar una estrategia que sitúe a tu marca en las respuestas de ChatGPT y Perplexity, revisa mi servicio de consultoría GEO y nos ponemos a trabajar sobre los datos de tu proyecto.