
Robots.txt para inteligencia artificial: cómo configurarlo para bloquear el entrenamiento o el acceso
Cuando la inteligencia artificial generativa explotó en el debate público, cundió el pánico en miles de empresas y medios de comunicación.
La reacción visceral de muchos administradores web fue correr al servidor, abrir el archivo robots.txt y meter directivas salvajes de bloqueo para impedir que OpenAI, Anthropic o Google les «robaran» sus contenidos.
Meses después, la resaca de esa decisión precipitada ha dejado una factura muy cara: webs que se han vuelto completamente invisibles en ChatGPT Search, Perplexity y las respuestas generativas de los buscadores.
El problema de fondo es que la inmensa mayoría de profesionales configuró su archivo sin entender una distinción técnica básica.
No todos los rastreadores de inteligencia artificial hacen lo mismo.
Existe una diferencia abismal entre bloquear el entrenamiento de futuros modelos y bloquear el acceso a la búsqueda y citación en tiempo real.
Si confundes esos dos conceptos, firmas tu propia desaparición digital.
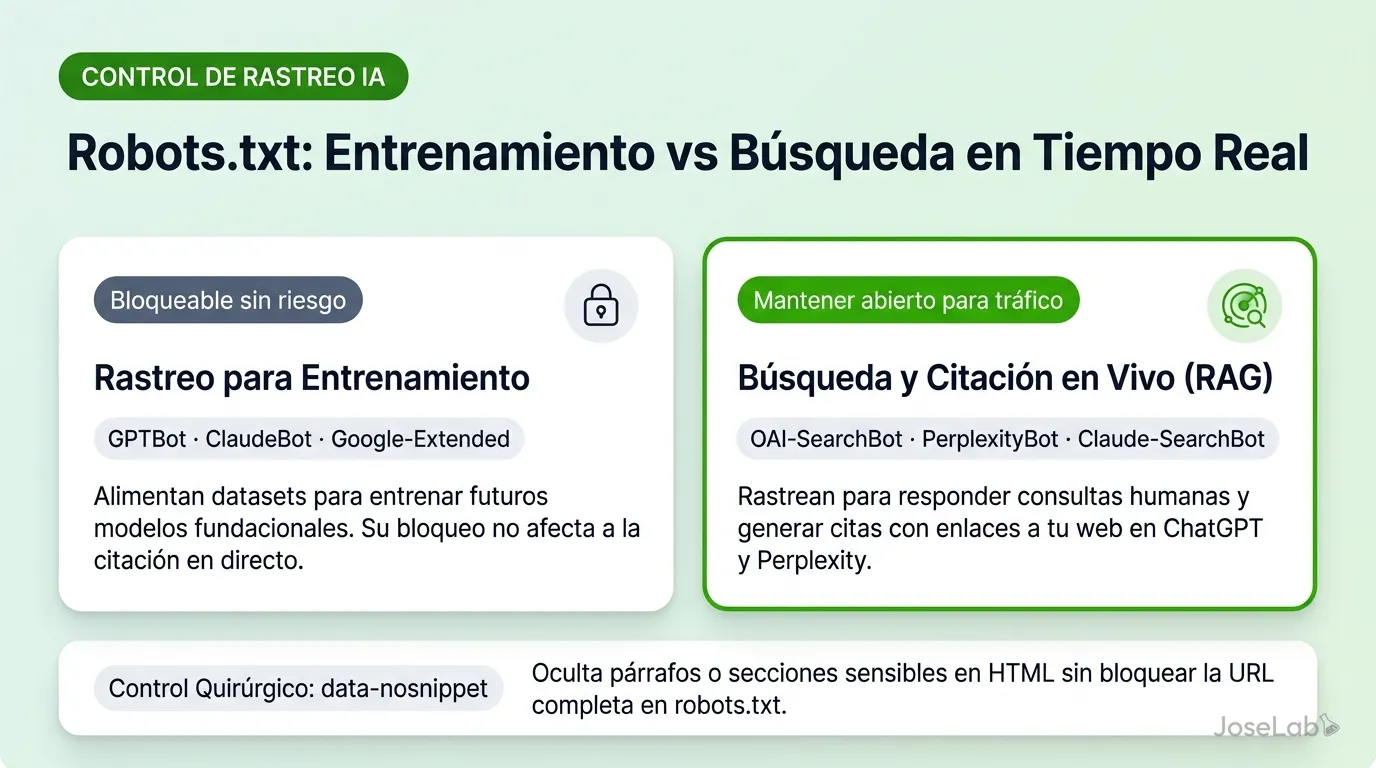
Bloqueo de entrenamiento vs. bloqueo de búsqueda: la frontera crítica
Para configurar tu archivo con cabeza, primero debes tener clarísimo qué hace cada tipo de rastreador cuando llama a la puerta de tu servidor.
Podemos agrupar a los bots de IA en dos familias completamente distintas:
1. Bots de entrenamiento (Scraping para modelos fundacionales)
Estos agentes navegan por la web recopilando millones de páginas para alimentar las bases de datos con las que las compañías entrenan sus siguientes versiones de modelos (por ejemplo, los datos que usarán OpenAI para GPT-5 o Anthropic para Claude 4).
- Propósito: Absorber conocimiento estático para el aprendizaje del modelo.
- Impacto en tu negocio: No te envían tráfico directo en ese momento ni te están mencionando en una respuesta en vivo; simplemente aprenden de tu texto.
- User-Agents principales:
GPTBot(OpenAI),ClaudeBot(Anthropic) yGoogle-Extended(Google).
Si no quieres que tus contenidos formen parte del dataset de entrenamiento de estas corporaciones, puedes bloquearlos sin miedo a perder tus clics de búsqueda.
2. Bots de búsqueda en tiempo real y RAG (Tráfico y citaciones)
Estos rastreadores operan de una manera radicalmente diferente. No entrenan modelos fundacionales; se activan para rastrear e indexar la web viva con el fin de responder a preguntas de usuarios humanos y colocar enlaces a tu página en sus carruseles de fuentes.
- Propósito: Búsqueda en vivo, recuperación aumentada por generación (RAG) y derivación de tráfico cualificado.
- Impacto en tu negocio: Son los responsables de que tu marca aparezca recomendada cuando un usuario pregunta por los mejores servicios de tu sector en ChatGPT o Perplexity.
- User-Agents principales:
OAI-SearchBot(OpenAI),PerplexityBot(Perplexity) yClaude-SearchBot(Anthropic).
Si bloqueas a estos rastreadores con un Disallow: /, la inteligencia artificial no podrá leer tus artículos ni verificar tus productos, dejándote automáticamente fuera de sus recomendaciones.
El catálogo oficial de User-Agents de IA que debes conocer
Para redactar reglas precisas en tu robots.txt, necesitas utilizar las firmas oficiales exactas que reconocen las compañías tecnológicas:
Ecosistema OpenAI (ChatGPT)
GPTBot: Rastreador de entrenamiento masivo. Bloquearlo impide que OpenAI entrene modelos con tu web.OAI-SearchBot: El motor de indexación de ChatGPT Search. Debes mantenerlo abierto si quieres recibir visitas y citaciones de fuentes desde ChatGPT.ChatGPT-User: Es el agente que se dispara cuando un usuario en una sesión interactiva le pide expresamente a ChatGPT que lea una URL concreta.
Ecosistema Perplexity AI
PerplexityBot: El crawler automatizado que indexa páginas para las respuestas de Perplexity. La compañía recalca oficialmente que este bot no se utiliza para entrenar modelos de IA, sino únicamente para indexar y enlazar fuentes.Perplexity-User: Se activa cuando un usuario humano introduce un enlace directo en la plataforma de Perplexity.
Ecosistema Anthropic (Claude)
ClaudeBot: Agente de recolección de datos para entrenamiento.Claude-SearchBot: Rastreador especializado para las funciones de búsqueda web en tiempo real dentro del ecosistema de Claude.Claude-User: Peticiones dinámicas disparadas por preguntas de usuarios en directo.
Ecosistema Google (Gemini y Search)
Google-Extended: El token que introdujo Google para permitir que los administradores web impidan que su contenido se utilice para entrenar a Gemini y Vertex AI.Googlebot: El rastreador histórico de Google Search.
El gran mito de Google-Extended y el control quirúrgico con data-nosnippet
Alrededor de Google existe una confusión gigantesca que veo repetirse una y otra vez en auditorías técnicas.
Muchos webmasters pensaban que añadiendo User-agent: Google-Extended con un Disallow: / en su archivo conseguían que Google dejase de usar sus contenidos en las AI Overviews (las respuestas con IA de los resultados de búsqueda).
Es completamente falso.
Google ha especificado con total claridad que Google-Extended solo afecta al entrenamiento de sus modelos de inteligencia artificial (Gemini y Vertex AI). Si bloqueas este bot, evitas que alimente a Gemini, pero tus contenidos seguirán apareciendo con normalidad en Google Search y en las AI Overviews, porque estas dependen exclusivamente de Googlebot.
Si de verdad quieres controlar qué partes de tu contenido aparecen en las respuestas generativas de Google Search, debes utilizar mecanismos diferentes:
1. El atributo data-nosnippet (Control a nivel de párrafo)
Si tienes fragmentos concretos en una página que no quieres que la inteligencia artificial sintetice (un precio dinámico, un bloque de metodología propia o una nota interna), no necesitas bloquear toda la URL en el robots.txt.
Puedes marcar ese bloque específico directamente en el código HTML:
<section data-nosnippet>
  Este texto específico no será extraído por las AI Overviews ni aparecerá en snippets de búsqueda.
</section>
Google respeta este atributo cuando se aplica sobre etiquetas <span>, <div> y <section>, permitiendo que el resto de tu página siga posicionando con normalidad.
2. El control de IA generativa en Google Search Console
Recientemente, Google ha habilitado un selector a nivel de propiedad en Search Console que permite desactivar la participación de tu web en las experiencias de búsqueda generativa (AI Overviews) sin sacrificar la indexación clásica ni los snippets de texto tradicionales.
La regla invisible de robots.txt: por qué los bots específicos ignoran el bloque general *
Aquí llegamos a un principio técnico crucial que pasa desapercibido incluso para desarrolladores experimentados: en el protocolo robots.txt (estándar RFC 9309), no existe la herencia de directivas.
Muchos profesionales asumen erróneamente que las reglas definidas bajo User-agent: * funcionan como una capa base universal que todos los bots acatan. Piensan que si ponen Disallow: /wp-admin/ o Disallow: /checkout/ en el bloque general *, ningún bot podrá entrar ahí.
La realidad técnica es muy distinta: un rastreador que encuentra un bloque con su nombre específico obedece única y exclusivamente las reglas de su bloque e ignora por completo el bloque general *.
Esto tiene un peligro descomunal:
Si creas un bloque para permitir a OAI-SearchBot o a PerplexityBot con una regla simple de Allow: /, ese bot no heredará tus bloqueos de /wp-admin/, /checkout/ o /privado/. Podrá rastrear tus páginas de pago, carritos y zonas privadas sin ninguna restricción.
Para solucionarlo, debes replicar siempre los bloqueos de carpetas sensibles dentro del bloque de los bots específicos de IA antes de abrir el acceso con Allow: /.
Además, por seguridad ante analizadores antiguos que evalúan reglas por orden de aparición en lugar de por longitud de ruta, es una buena práctica colocar siempre las directivas Allow más específicas antes del Disallow general (por ejemplo, Allow: /wp-admin/admin-ajax.php antes de Disallow: /wp-admin/).
El peligro real de pedirle a una IA que redacte tu robots.txt
En mi trabajo diario como consultor, me encuentro con una tendencia cada vez más extendida y peligrosa: clientes que le piden a ChatGPT o a Claude que les redacte las reglas de su robots.txt.
El resultado suele ser desastroso.
Los modelos de lenguaje no tienen una visión integral de la infraestructura de tu servidor ni entienden la jerarquía de precedencia del estándar robots. A menudo generan directivas contradictorias que causan estragos:
- Bloqueos involuntarios de acceso: He vivido casos de clientes que acudieron a mí tras perder tráfico porque le habían pedido a la IA «dar acceso a los bots de búsqueda» y el modelo les generó una combinación de reglas de
AllowyDisallowtan mal redactada que terminó bloqueando por completo a los bots de IA de forma no intencionada. - Cierre de recursos críticos: Modelos que recomiendan bloquear carpetas como
/assets/,/wp-content/o archivos.js, impidiendo que los motores de búsqueda rendericen el contenido y provocando caídas de posicionamiento. - Falso control de indexación: Directivas absurdas como intentar poner
Noindex:dentro delrobots.txt, una instrucción que Google dejó de soportar oficialmente hace años.
La inteligencia artificial puede servirte para consultar la sintaxis de un User-Agent, pero la configuración de un robots.txt debe estar siempre validada manualmente por un consultor SEO. Un solo carácter mal colocado en este archivo puede dejar a tu empresa fuera del mapa digital en cuestión de horas.
Cheatsheet de configuración: plantillas recomendadas para tu web
Para evitarte sustos y errores de bulto, aquí tienes dos configuraciones limpias, blindadas contra problemas de herencia y probadas según la estrategia de tu proyecto.
Un apunte vital antes de copiar el código: en tiendas online sobre WooCommerce o plataformas en español, los slugs de compra suelen llamarse /finalizar-compra/, /carrito/ o /mi-cuenta/, mientras que en configuraciones en inglés o personalizadas verás /checkout/ o /cart/. Como robots.txt evalúa prefijos de ruta exactos, comprueba las URLs reales de tu web para asegurar que no dejas desprotegidos tus procesos transaccionales.
Opción 1: La recomendada (Bloquear entrenamiento pero permitir búsqueda y citaciones)
Esta es la configuración idónea para la inmensa mayoría de empresas y profesionales: proteges tu contenido para que no entrenen modelos fundacionales con tus textos, pero mantienes abiertas las puertas a todos los bots que te traen tráfico y citaciones de fuentes, protegiendo tus carpetas privadas en todos los frentes.
# 1. Bloquear rastreo para entrenamiento de modelos fundacionales
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

# 2. Permitir indexación para búsqueda en tiempo real y citaciones en IA
# (Replicamos los bloqueos sensibles porque los bots específicos NO heredan de *)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-admin/
Disallow: /checkout/
Disallow: /finalizar-compra/
Disallow: /carrito/
Disallow: /mi-cuenta/
Disallow: /privado/
Allow: /

# 3. Reglas para el resto de rastreadores y buscadores clásicos
User-agent: *
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-admin/
Disallow: /checkout/
Disallow: /finalizar-compra/
Disallow: /carrito/
Disallow: /mi-cuenta/
Disallow: /privado/

Sitemap: https://tudominio.com/sitemap_index.xml
Opción 2: Máxima apertura para visibilidad GEO agresiva
Si tu prioridad absoluta es la máxima difusión de marca y quieres que los principales modelos (tanto de búsqueda como de entrenamiento) tengan acceso a tu contenido público para maximizar tu cuota de presencia (Share of Model):
# 1. Permitir acceso explícito a bots de búsqueda y bots de entrenamiento
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-admin/
Disallow: /checkout/
Disallow: /finalizar-compra/
Disallow: /carrito/
Disallow: /mi-cuenta/
Disallow: /privado/
Allow: /

# 2. Reglas para el resto de rastreadores
User-agent: *
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-admin/
Disallow: /checkout/
Disallow: /finalizar-compra/
Disallow: /carrito/
Disallow: /mi-cuenta/
Disallow: /privado/

Sitemap: https://tudominio.com/sitemap_index.xml
El archivo robots.txt ha dejado de ser un simple filtro para evitar páginas duplicadas; hoy es el panel de control que decide si tu negocio existe o no dentro de los asistentes generativos.
Si tienes dudas sobre qué bots están accediendo a tu web o quieres realizar una auditoría técnica para asegurar que tus directivas de servidor no están frenando tu visibilidad, revisa mi servicio de consultoría GEO y analizamos la configuración de tu proyecto al milímetro.